3. 무엇을 param으로, 무엇을 metric으로
이 장에서 처음 나오는 말4개
평탄화flatten- 중첩 dict를
lgbm.learning_rate처럼 한 단계 key로 펴는 일. MLflow의 param은 중첩을 모른다. step- 같은 metric key를 여러 번 기록할 때의 순번. epoch·fold처럼 진행에 따른 곡선을 만든다.
비유한값non-finite- NaN(계산 불능)과 ±inf(발산). 지표 계산에서 분모가 0이 되면 자연스럽게 나온다.
system tagmlflow.로 시작하는 예약 tag. MLflow가 실행 환경 정보를 채운다.
하나의 run을 여는 방법
섹션 제목: “하나의 run을 여는 방법”기록은 항상 활성화된 run 안에서 일어난다. context manager를 쓰면 정상 종료 시 FINISHED, 예외 발생 시
FAILED로 상태가 자동으로 정리된다.
with mlflow.start_run( experiment_id=exp_id, run_name="nxt_daily_o2n_20260830_120331", # mlflow.runName tag가 된다 tags={"phase": "final", "variant": "best"}, # 생성 시점에 붙이는 tag) as run: mlflow.log_params(...) mlflow.log_metrics(...) ...print(run.info.run_id)전체 시그니처에서 알아 둘 인자는 넷이다.
| 인자 | 쓰임 |
|---|---|
run_name | 사람이 읽는 이름. 생략하면 MLflow가 carefree-hog-241 같은 이름을 붙인다 |
tags | 생성과 동시에 붙는 tag. 나중에 set_tag()로 추가·수정할 수 있다 |
nested | 자식 run으로 만들지 여부. 7장에서 쓴다 |
run_id | 기존 run을 이어서 연다. 끝난 run에 나중에 metric을 덧붙일 때 쓴다 |
run_name은 반드시 넣는 편이 좋다. sshim-trader가 nxt_daily_o2n_20260830_120331처럼 산출물 폴더 이름을
그대로 쓰는 것은 UI의 행과 디스크의 폴더를 눈으로 잇는 좋은 관례다.
param — 한 번 쓰면 못 바꾼다
섹션 제목: “param — 한 번 쓰면 못 바꾼다”mlflow.log_params({"train_days": 750, "step_days": 60})param에는 세 가지 규칙이 있고 셋 다 나중에 문제가 된다.
숫자를 넣어도 DB에는 문자열로 들어간다. 그래서 검색에서 params.step_days > 60 같은 수치 비교가 안 되고
params.step_days = '120'처럼 문자열 등가 비교만 된다. 정렬도 사전순이라 '120' < '60'이다.
결론: 나중에 범위로 물어볼 값이면 param과 함께 metric으로도 남기는 걸 고려한다.
값이 다르면 예외다.
MlflowException: Changing param values is not allowed. Param with key='p'was already logged with value='[1, 2, 3]' for run ID='03e8fcf1…'.같은 값을 다시 쓰는 건 통과한다. 그래서 “이미 기록했는지” 걱정하지 않고 멱등하게 부를 수는 있지만, 실행 도중에 값이 바뀌는 것은 param이 아니라 metric이나 tag여야 한다는 뜻이기도 하다.
값은 6000자, key는 250자까지다. key에 쓸 수 있는 문자는 영숫자·_·-·.·공백·:·/뿐이라
bad key! 같은 이름은 거부된다.
6000자 제한은 실제로 걸릴 수 있다. 백테스트가 **raw_config로 YAML 전체를 param에 펼치는데,
sell_algos·buy_algos는 dict의 list라 평탄화가 안으로 못 들어가고 통째로 문자열 하나가 된다.
알고리즘 조합이 길어지면 그 값 하나가 제한에 다가간다.
중첩 dict를 펴는 이유
섹션 제목: “중첩 dict를 펴는 이유”MLflow param은 평평한 key-value다. {"lgbm": {"learning_rate": 0.05}}를 그대로 넣으면 값이
"{'learning_rate': 0.05, ...}"라는 문자열 한 덩어리가 되어 검색도 비교도 못 한다.
tracking.py의 flatten_params()가 이걸 푼다.
def flatten_params(params: dict[str, Any], prefix: str = "") -> dict[str, Any]: flat: dict[str, Any] = {} for key, value in params.items(): name = f"{prefix}{key}" if isinstance(value, dict): flat.update(flatten_params(value, f"{name}.")) else: flat[name] = str(value) if isinstance(value, (list, tuple)) else value return flat결과가 실제 DB에 이렇게 들어간다.
lgbm.objective regressionlgbm.n_estimators 400lgbm.learning_rate 0.05lgbm.num_leaves 63lgbm.min_child_samples 100이제 UI에서 lgbm.learning_rate 열을 켜고 정렬할 수 있고, params.lgbm.num_leaves = '63'으로 검색할 수 있다.
.가 key에 허용되는 문자라 이 규칙이 성립한다.
metric — 비유한값이 조용히 망가진다
섹션 제목: “metric — 비유한값이 조용히 망가진다”mlflow.log_metrics({"sharpe_net": 0.83, "mdd": -0.21})metric은 float만 받는다. 그런데 MLflow는 NaN과 inf를 거부하지 않는다. sqlite backend에서 직접 확인한 결과는 이렇다.
| 넣은 값 | 저장된 값 |
|---|---|
float("nan") | nan 그대로 |
float("inf") | 1.7976931348623157e+308 (float 최대값) |
float("-inf") | -1.7976931348623157e+308 |
inf가 float 최대값으로 바뀌는 게 특히 나쁘다. 오류 없이 통과한 뒤 차트의 y축이 1e308까지 늘어나
같은 실험의 다른 런이 전부 바닥에 깔리고, 정렬하면 그 런이 항상 1등이 된다. _summarize()가
net.std() > 0이 아닐 때 nan을 돌려주고 있으니 실제로 나올 수 있는 값이다.
tracking.py가 이걸 막는다.
numeric: dict[str, float] = {}for key, value in metrics.items(): try: v = float(value) except (TypeError, ValueError): continue # 문자열·None 등은 건너뛴다 if math.isfinite(v): numeric[key] = v # NaN·inf는 아예 기록하지 않는다이 필터는 pandas Series를 그대로 넘기는 호출부(dict(lgbm.items()))와 짝을 이룬다. numpy 스칼라도
float()로 정규화되고, 지표 계산이 실패한 항목은 행 자체가 없는 상태로 남는다.
step으로 곡선 남기기
섹션 제목: “step으로 곡선 남기기”metric은 같은 key를 여러 번 기록할 수 있고, 그때 순번이 step이다.
mlflow.log_metric("fold_sharpe", value, step=fold_index)이건 1장에서 미뤄 둔 문제 — fold별 숫자를 보고 싶은데 run을 늘리고 싶지는 않은 상황 — 의 답이다. run 하나 안에서 fold 진행에 따른 곡선이 되고, UI가 자동으로 선 그래프로 그린다.
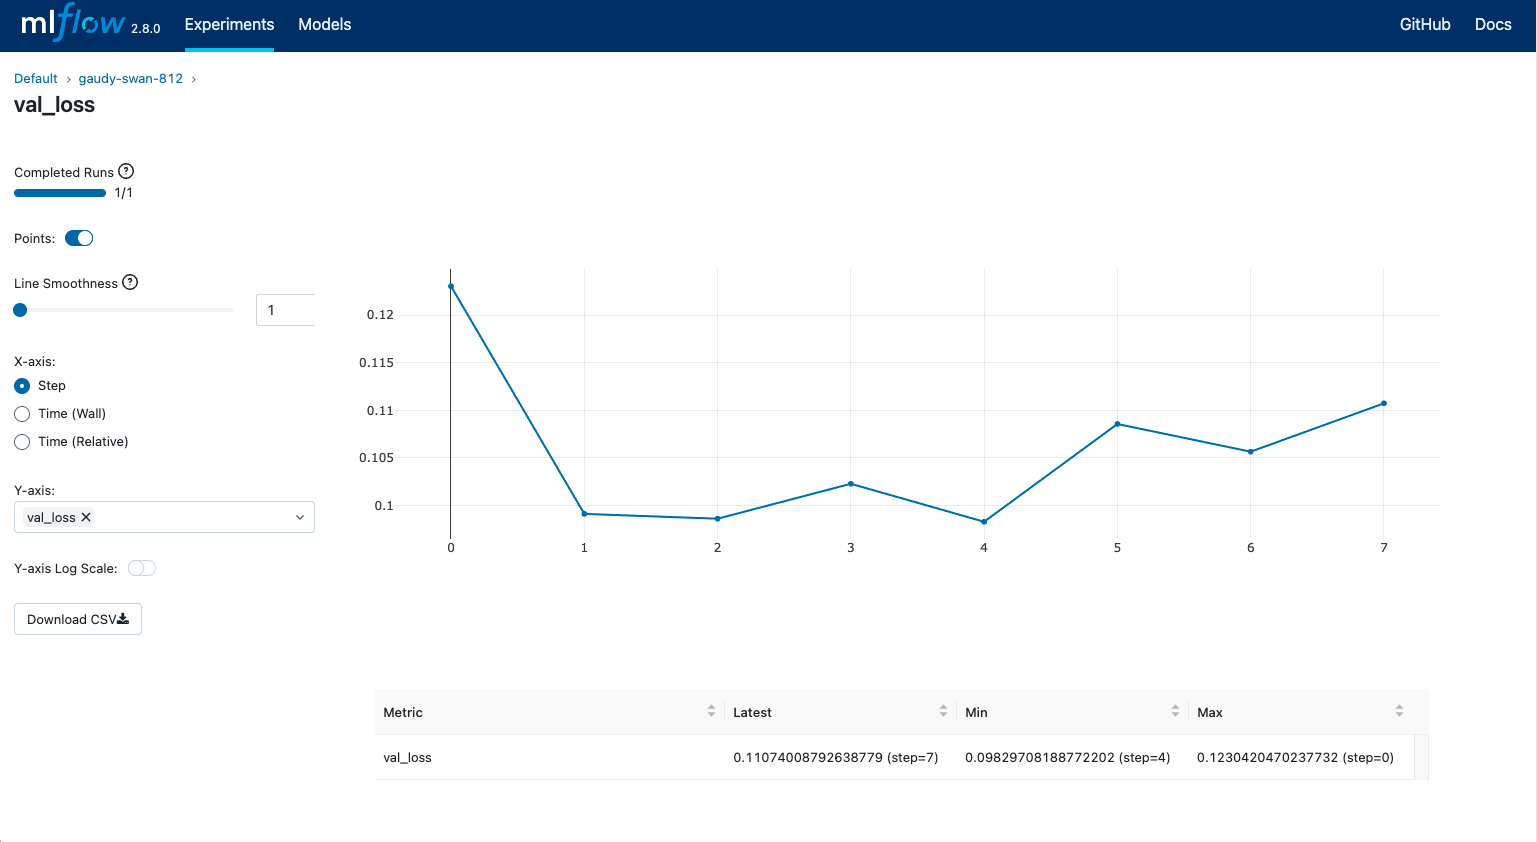
run 목록에는 마지막 step의 값이 대표로 뜬다. walk-forward에 이걸 붙인다면 fold별 지표는 step으로 쌓되,
전체 구간 합산 지표는 sharpe_net처럼 step 없는 별도 key로 따로 남기는 편이 헷갈리지 않는다.
tag — 나중에 고칠 수 있는 유일한 것
섹션 제목: “tag — 나중에 고칠 수 있는 유일한 것”mlflow.set_tag("phase", "final")mlflow.set_tags({"study": "nxt_daily_o2n", "variant": "best"})tag는 param과 달리 덮어쓸 수 있다. 그래서 실행 시점에는 몰랐던 판단을 나중에 붙이는 자리로 쓴다.
| 지금 sshim-trader가 쓰는 tag | 붙이는 곳 | 뜻 |
|---|---|---|
study | research_tune.py | 어느 Optuna study에 속한 런인가 |
phase | research_tune.py | tune(탐색 중) / final(최종 검증) |
trial | research_tune.py | trial 번호 |
variant | research_tune.py | default / best |
out_dir | 세 곳 모두 | 이 런의 산출물 폴더 경로 |
여기에 사후 판단을 얹으면 tag가 훨씬 강해진다. 예를 들어 검토를 끝낸 런에 decision=rejected,
reason=holdout에서 무너짐을 붙여 두면, 반년 뒤 같은 방향을 다시 시도할 때 검색으로 걸린다.
from mlflow import MlflowClient
client = MlflowClient("sqlite:///artifacts/mlflow.db")client.set_tag(run_id, "decision", "rejected")client.set_tag(run_id, "reason", "holdout Sharpe가 튜닝 구간의 절반")mlflow.로 시작하는 이름은 MLflow 예약이므로 내 tag에는 쓰지 않는다. 자동으로 붙는 system tag 목록은
1장에 있다.