1. experiment · run과 그 안의 네 가지
이 장에서 처음 나오는 말5개
experiment- 같은 목적의 run을 담는 이름 있는 묶음. run은 반드시 하나의 experiment에 속한다.
run- 실행 하나.
run_id라는 32자 hex 식별자를 가지며 param·metric·tag·artifact가 여기에 붙는다. run_name- 사람이 읽는 이름. 실제로는
mlflow.runName이라는 tag로 저장되어 나중에 바꿀 수 있다. lifecycle stage- run이
active인지deleted인지. UI의 삭제는deleted표시일 뿐 실제 삭제가 아니다. LoggedModel- MLflow 3에서 1급 개체가 된 "기록된 모델". run에 딸린 파일이 아니라 자체 id와 metric을 가진다.
전체 그림
섹션 제목: “전체 그림”MLflow의 저장 단위는 세 층이다. experiment가 run을 담고, run이 param·metric·tag·artifact를 담는다. tag는 experiment에도 run에도 붙을 수 있다.
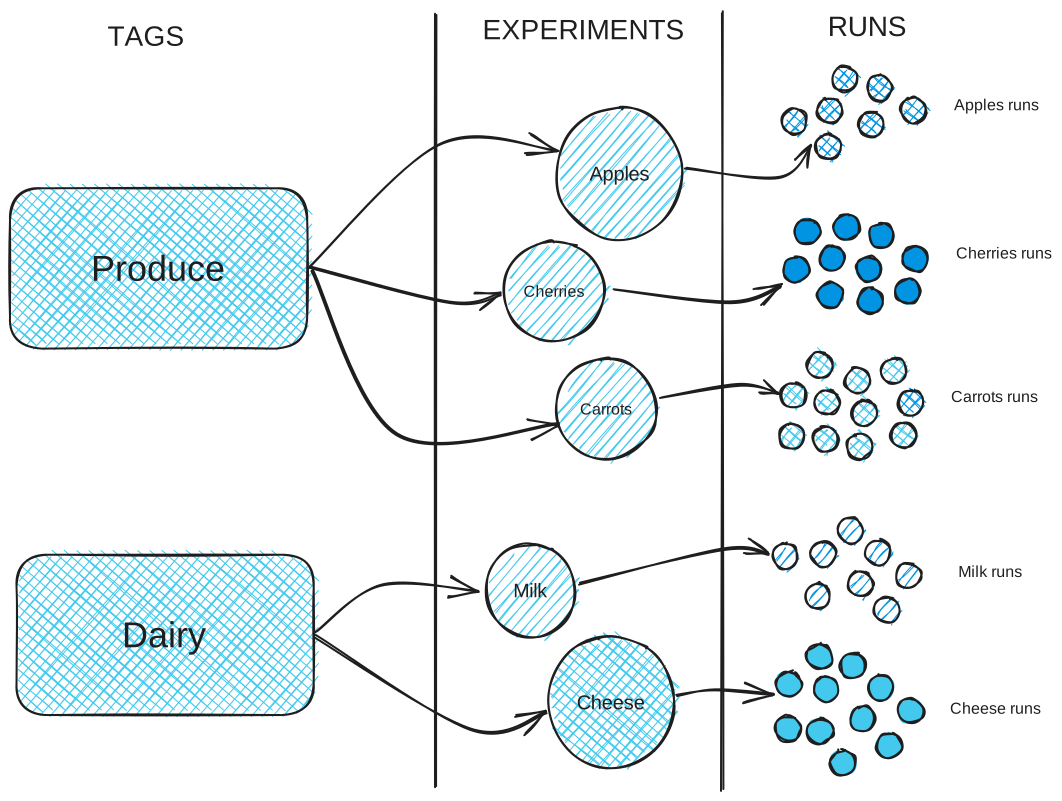
sshim-trader에는 지금 experiment가 넷 있다. Default는 MLflow가 자동으로 만든 것이고 나머지 셋이 실제 사용처다.
| experiment | 만드는 곳 | 한 run이 뜻하는 것 |
|---|---|---|
research/nxt_daily_o2n | scripts/research_nxt_daily.py | walk-forward 연구 실행 1회 |
research/tune_o2n | scripts/research_tune.py | Optuna trial 1개 또는 최종 검증 1개 |
backtest | sshim_trader/backtest/__main__.py | 백테스트 config 1개의 실행 |
log_run()의 인자와 데이터 모델의 대응
섹션 제목: “log_run()의 인자와 데이터 모델의 대응”sshim_trader/utils/tracking.py의 시그니처를 그대로 놓고 보면 MLflow 데이터 모델과 1:1로 붙는다.
def log_run( experiment: str, # experiment 이름 params: dict[str, Any], # → mlflow.log_params() metrics: dict[str, Any], # → mlflow.log_metrics() artifact_paths: Sequence[Path | str] = (), # → mlflow.log_artifact(s)() run_name: str | None = None, # → mlflow.runName tag tags: dict[str, str] | None = None, # → run tag) -> str | None: # run_id| MLflow 개체 | 저장 형태 | 나중에 바꿀 수 있나 | 무엇에 쓰나 |
|---|---|---|---|
| param | 문자열 (최대 6000자) | 아니오 — 같은 key 재기록은 오류 | 조건 확인, 그룹 비교 |
| metric | 실수 + step + timestamp | 예 — 같은 key를 여러 step으로 쌓음 | 수치 조건 검색, 정렬, 차트 |
| tag | 문자열 (최대 8000자) | 예 | 분류, 거르기, 메모 |
| artifact | 파일 | 덧붙이기만 | 리포트·예측·모델처럼 값이 아닌 것 |
key 길이 제한은 셋 다 250자다. lgbm.min_child_samples처럼 평탄화한 이름은 여유롭게 들어간다.
run 하나를 어느 크기로 자를 것인가
섹션 제목: “run 하나를 어느 크기로 자를 것인가”이게 이 장에서 가장 중요한 결정이다. 기준은 “내가 통째로 채택하거나 기각할 대상”이다.

- walk-forward 연구 1회 = run 1개. 안에서 fold가 스무 번 돌아도 내가 보는 건 합쳐진 지표 하나다. fold마다 run을 만들면 experiment가 의미 없는 행으로 가득 찬다.
- Optuna trial 1개 = run 1개. trial 30개는 후보 30개이므로 run도 30개다. 다만 이렇게 하면 한 study가 30행을 만들어 experiment가 금세 지저분해지는데, 이 문제는 7장의 parent/child run에서 푼다.
- 백테스트 config 1개 = run 1개.
configs/*.yaml하나가 조건 한 벌이므로 자연스럽게 맞는다.
fold별 숫자를 꼭 보고 싶다면 run을 늘리는 대신 같은 metric을 step으로 쌓는다. log_metric("fold_sharpe", v, step=i)처럼
쓰면 run 하나 안에서 fold 진행에 따른 곡선이 된다. 이건 3장에서 다룬다.
run에 자동으로 붙는 것
섹션 제목: “run에 자동으로 붙는 것”mlflow.start_run()은 내가 준 것 외에도 몇 가지를 알아서 채운다. sshim-trader의 artifacts/mlflow.db에
실제로 들어 있는 tag가 그 증거다.
| 자동 tag | 값의 예 | 언제 붙나 |
|---|---|---|
mlflow.runName | nxt_daily_o2n_20260830_120331 | run_name을 줬거나 MLflow가 임의 이름을 지을 때 |
mlflow.user | 실행한 OS 사용자 | 항상 |
mlflow.source.name | scripts/research_tune.py | 스크립트로 실행할 때 |
mlflow.source.type | LOCAL | 항상 |
mlflow.source.git.commit | 커밋 해시 | git 작업 트리 안에서 실행할 때 |
mlflow.source.git.branch · repoURL | main · 원격 주소 | 위와 같음 |
mlflow.parentRunId | 부모 run_id | nested=True로 만든 자식 run일 때 |
mlflow.source.git.commit이 공짜로 붙는다는 사실이 중요하다. “이 결과가 어떤 코드에서 나왔나”라는
질문이 이미 답해져 있다. 다만 uncommitted 변경까지는 알려주지 않는다 — 자세한 건
10장에서 다룬다.
run에는 상태도 함께 저장된다. status는 RUNNING → FINISHED/FAILED/KILLED로 바뀌고,
lifecycle_stage는 active 또는 deleted다. UI에서 run을 지워도 deleted 표시만 될 뿐 파일과 행은 남는다.
진짜로 지우려면 11장의 mlflow gc가 필요하다.
MLflow 3에서 하나 늘어난 층
섹션 제목: “MLflow 3에서 하나 늘어난 층”MLflow 2까지는 모델이 run에 딸린 artifact 폴더였다. MLflow 3부터는 LoggedModel이 자체 id를 가진 개체가 되어, run과 나란히 서고 자기 metric을 가진다.
MLflow 2: experiment → run → artifacts/model/ (모델은 파일)MLflow 3: experiment → run ─┬─ params · metrics · tags └─ LoggedModel (model_id) ─ 자체 metric · tag지금 sshim-trader는 모델을 전혀 기록하지 않으므로 이 층이 비어 있다. 하지만 walk-forward의 마지막 fold
모델을 실거래에 실으려는 순간 필요해지고, 그때 models:/<model_id> 같은 URI가 등장한다.
8장에서 다룬다.