2. tracking URI와 두 개의 저장소
이 장에서 처음 나오는 말4개
tracking URI- client가 기록을 보낼 곳의 주소. 파일 경로, DB 접속 문자열, 또는
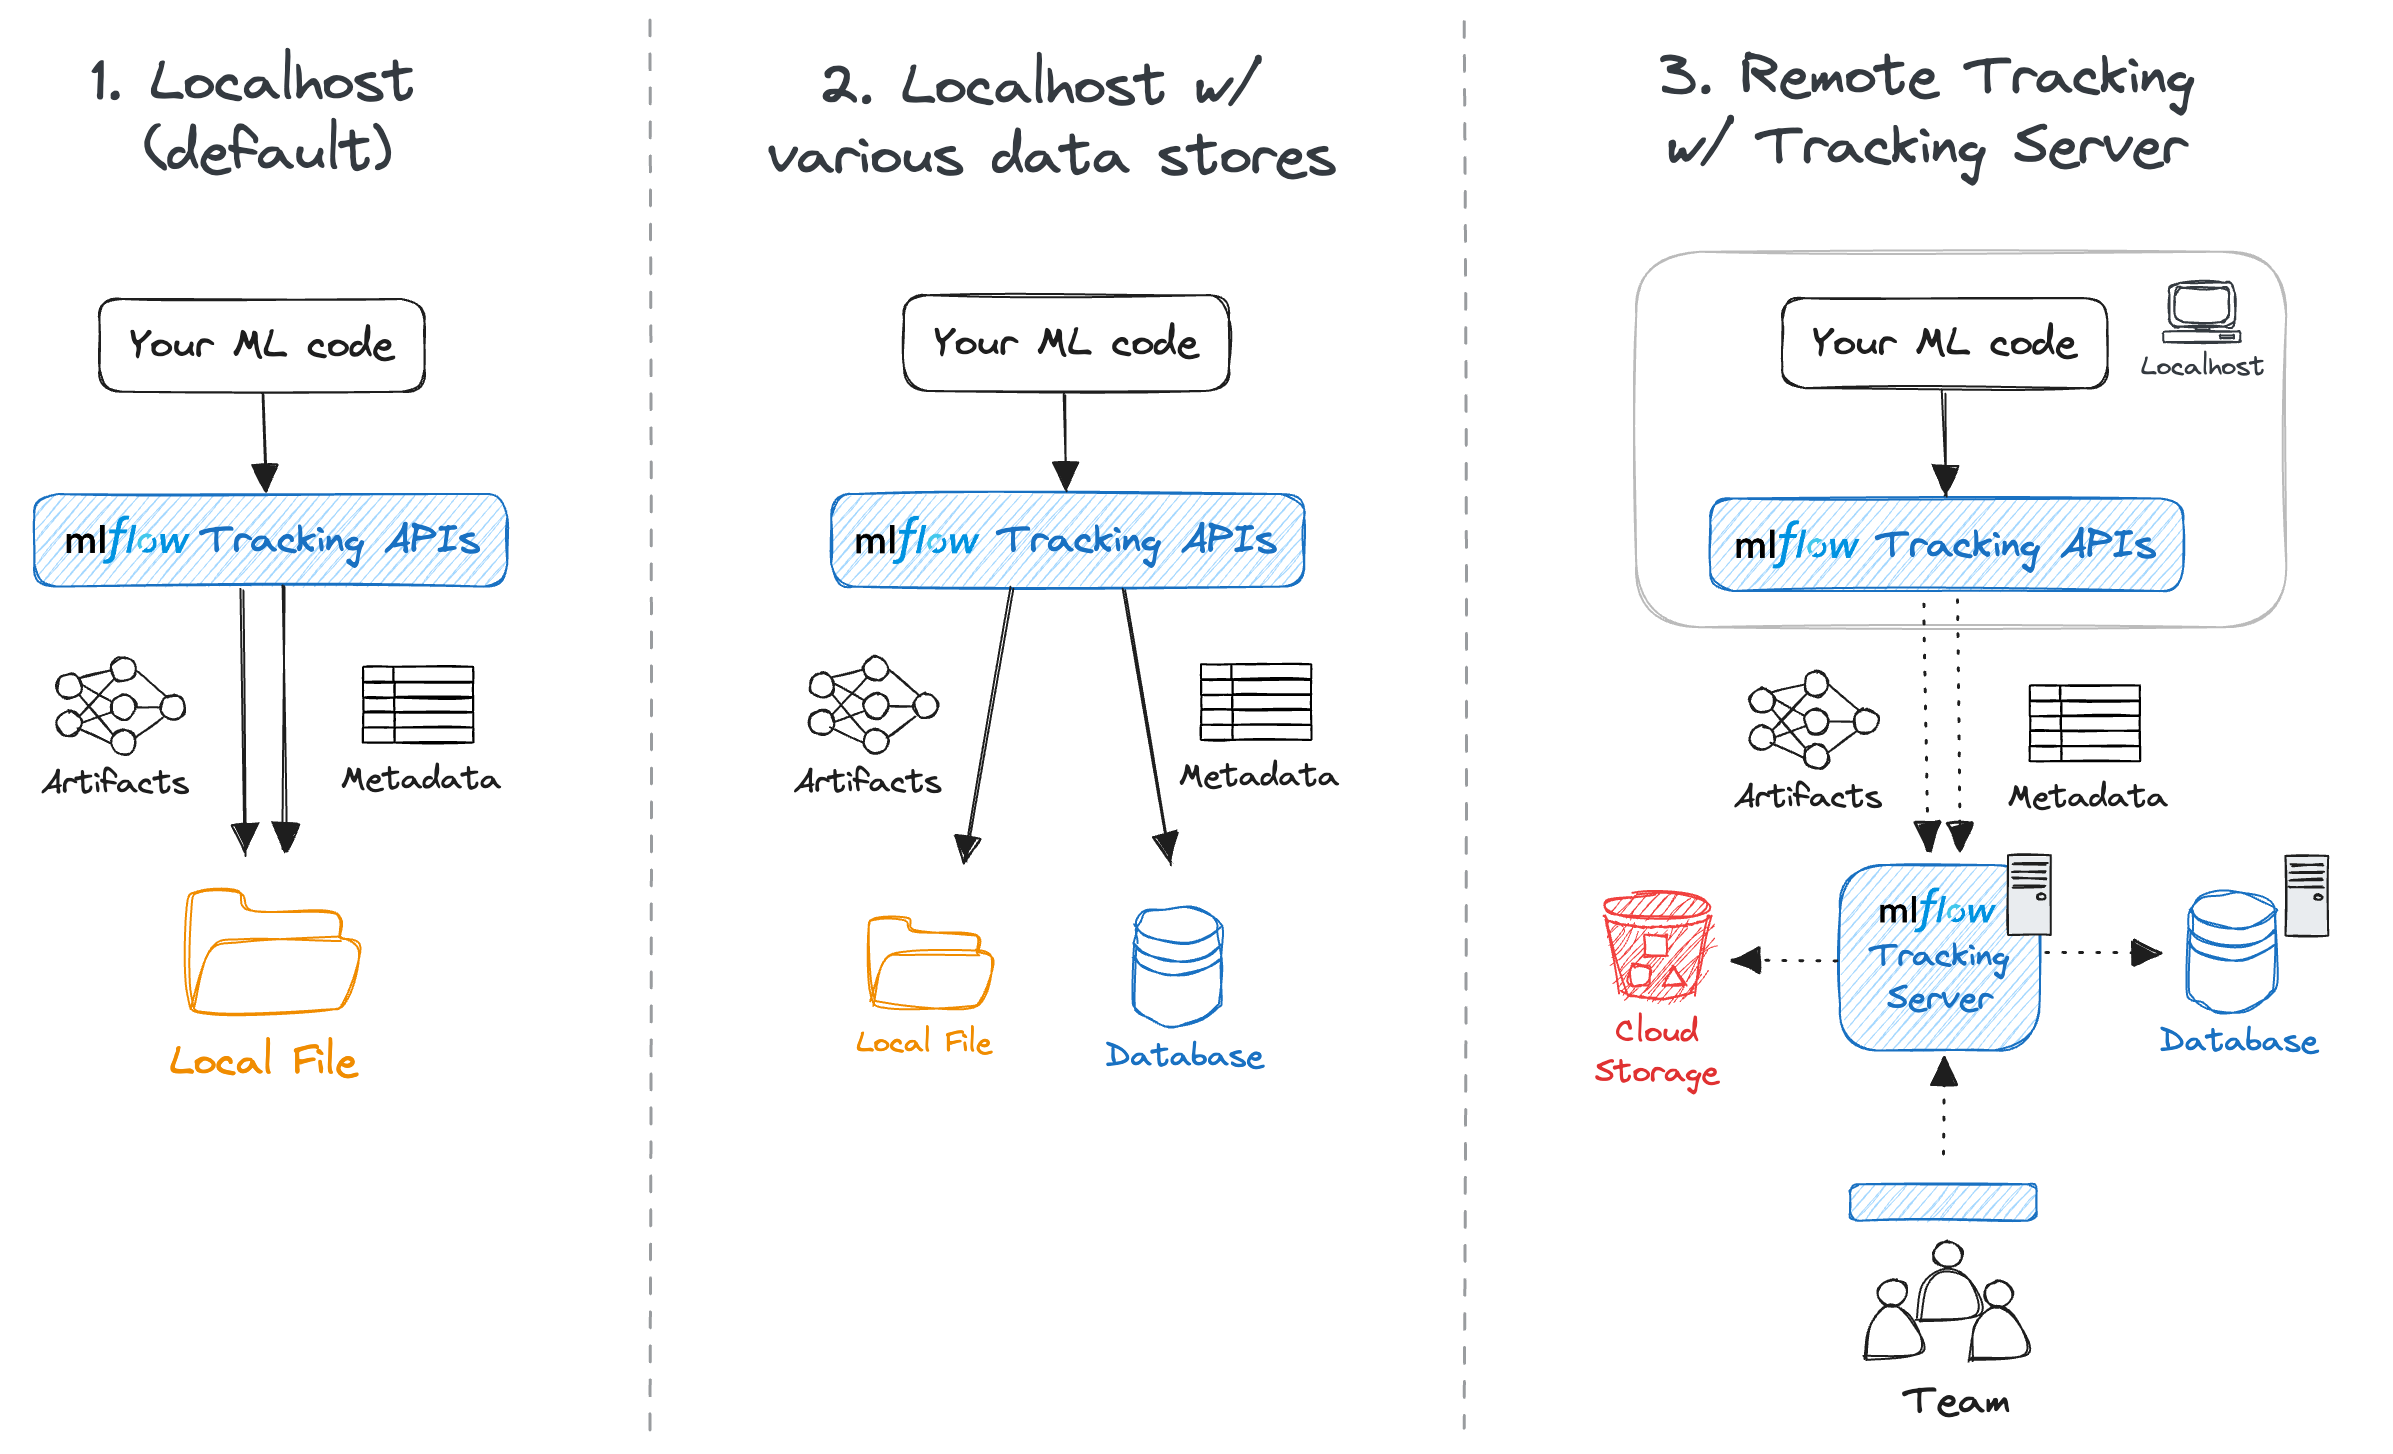
http://서버 주소다. backend store- run·param·metric·tag 같은 구조화된 metadata를 담는 곳. sqlite·PostgreSQL 같은 DB나 파일 디렉터리다.
artifact store- 리포트·모델·데이터처럼 큰 파일을 담는 곳. 로컬 디렉터리나 S3 같은 object storage다.
tracking server- REST API와 UI를 제공하는 HTTP 서버. 로컬 1인 사용에서는 없어도 된다.
왜 저장소가 둘인가
섹션 제목: “왜 저장소가 둘인가”sharpe_net = 0.83 같은 값과 40MB짜리 predictions.parquet은 성질이 다르다. 앞은 수천 개를 한 번에
정렬·필터해야 하고, 뒤는 필요할 때 한 번 내려받으면 된다. MLflow는 이 둘을 아예 다른 저장소로 나눈다.
공식 문서는 이 구성을 세 가지 배치로 정리한다. sshim-trader는 맨 왼쪽, 서버 없이 client가 로컬 저장소에 직접 붙는 형태다.
sshim-trader의 실제 설정
섹션 제목: “sshim-trader의 실제 설정”sshim_trader/utils/tracking.py가 하는 설정은 두 줄이다.
TRACKING_DB = Path("artifacts/mlflow.db")        # 상대 경로ARTIFACT_ROOT = Path("artifacts/mlruns")         # 상대 경로
mlflow.set_tracking_uri(f"sqlite:///{TRACKING_DB}")exp = mlflow.get_experiment_by_name(experiment)exp_id = exp.experiment_id if exp else mlflow.create_experiment(    experiment, artifact_location=str(ARTIFACT_ROOT.resolve())   # 여기서 절대 경로로 바뀐다)
두 경로의 운명이 갈리는 지점이 resolve() 하나다.
| 항목 | 저장되는 형태 | 결과 |
|---|---|---|
| tracking URI | sqlite:///artifacts/mlflow.db (상대) | 실행 디렉터리가 바뀌면 다른 DB를 본다 |
| artifact location | /Users/…/sshim-trader/artifacts/mlruns (절대) | 실행 위치와 무관하지만 레포를 옮기면 깨진다 |
절대 경로 쪽에도 대가가 있다. artifacts/mlflow.db에는 지금 이런 값이 들어 있다.
artifact_uri = /Users/sshim/workspace/sshim-trader/artifacts/mlruns/e94895…/artifacts레포를 다른 경로나 다른 기기로 옮기면 이 URI가 가리키는 곳이 사라진다. metadata는 멀쩡한데 artifact만
못 여는 상태가 된다. 1인 로컬 환경에서는 감수할 만한 거래지만, mlflow.db를 백업·이전할 때는
경로가 함께 이사한다는 걸 기억해야 한다.
환경 변수로 덮어쓰기
섹션 제목: “환경 변수로 덮어쓰기”코드를 고치지 않고 다른 저장소를 보게 하려면 MLFLOW_TRACKING_URI를 쓴다. set_tracking_uri() 호출이
있으면 코드가 이기지만, 실험적으로 다른 DB를 붙여 볼 때는 환경 변수가 편하다.
# 코드가 set_tracking_uri를 부르지 않는 경우에만 유효하다export MLFLOW_TRACKING_URI=sqlite:///$PWD/artifacts/mlflow.db우선순위는 명시적 set_tracking_uri() → MLFLOW_TRACKING_URI → 기본값 순이다. MLflow 3의 기본값은
현재 디렉터리의 sqlite:///mlflow.db이고, 기존 ./mlruns file store가 이미 있으면 그쪽으로 되돌아간다 —
서버와 같은 규칙이다 (설치된 3.15.2에서 확인했다). 지금 코드는 항상 첫 번째를 쓰므로 환경 변수는 무시된다.
이걸 알고 있어야 “환경 변수를 바꿨는데 왜 그대로지”에서 헤매지 않는다.
artifact_location은 experiment를 만들 때 한 번만 정해진다
섹션 제목: “artifact_location은 experiment를 만들 때 한 번만 정해진다”create_experiment(..., artifact_location=...)은 생성 시점에만 반영된다. 이미 있는 experiment의
artifact 위치는 나중에 바꿀 수 없다. log_run()이 get_experiment_by_name으로 먼저 찾고 없을 때만
만드는 구조라, 이미 만들어진 experiment는 옛 설정을 그대로 유지한다.
sshim-trader의 DB가 그 흔적을 보여 준다.
| experiment | artifact_location | 왜 |
|---|---|---|
Default | <repo>/mlruns/0 | MLflow가 자동 생성 — artifact_location을 준 적이 없다 |
research/nxt_daily_o2n | <repo>/artifacts/mlruns | log_run()이 만들면서 지정했다 |
backtest | <repo>/artifacts/mlruns | 위와 같음 |
세 experiment가 같은 artifacts/mlruns를 공유해도 충돌하지 않는다. 실제 파일은
<artifact_location>/<run_id>/artifacts/ 아래로 들어가고 run_id가 유일하기 때문이다.
artifacts/mlruns/├── a11b704899ad4312a3be22bb23c56497/artifacts/ # backtest 런│ ├── summary.json · trades.csv · equity.csv · report.html└── e9489504b5f64a6fb07a9b7b45b73b55/artifacts/ # walk-forward 런 ├── predictions.parquet · summary.csv · report.htmlUI 띄우기
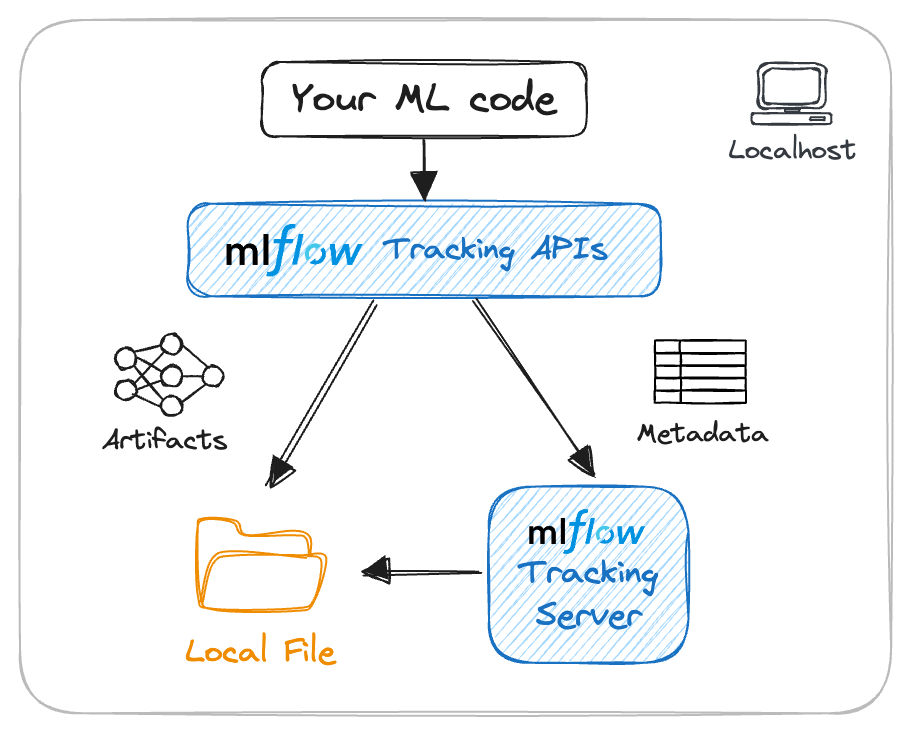
섹션 제목: “UI 띄우기”mlflow ui는 MLflow 3에서 mlflow server와 같은 명령이다. 설명 자체가 “Run the MLflow tracking server
(UI + REST API)“이고, 인자 없이 띄우면 sqlite:///mlflow.db를 기본으로 쓰되 ./mlruns file store가 있으면
그쪽으로 되돌아간다. 즉 아무 인자 없이 띄우면 우리 DB가 아닌 곳을 볼 수 있다.
그래서 레포는 pyproject.toml에 진입점을 하나 만들어 뒀다.
[project.scripts]mlflow-ui = "sshim_trader.utils.tracking:main_ui"-
레포 루트에서 UI를 연다.
main_ui()가--backend-store-uri sqlite:///artifacts/mlflow.db를 대신 붙여 준다.터미널 창 uv run mlflow-ui -
포트를 바꾸고 싶으면 인자를 그대로 넘긴다. 추가 인자는
mlflow ui로 전달된다.터미널 창 uv run mlflow-ui --port 5001 -
진입점을 안 쓰고 직접 칠 수도 있다. 이 형태가 스크립트 docstring에도 적혀 있다.
터미널 창 uv run mlflow ui --backend-store-uri sqlite:///artifacts/mlflow.db
이 구성은 공식 문서의 “로컬 DB를 backend store로 쓰는” 배치에 해당한다.
기본 backend가 file store(./mlruns 디렉터리)가 아니라 sqlite인 이유도 알아 둘 만하다. file store는
유지보수 모드이고, Model Registry와 빠른 검색은 DB backend에서만 동작한다. sqlite도 엄연한 DB backend라
9장의 Model Registry를 지금 구성 그대로 쓸 수 있다.
.gitignore에서 확인할 것
섹션 제목: “.gitignore에서 확인할 것”artifacts/는 sshim-trader에서 생성 산출물이다. mlflow.db와 mlruns/가 커밋에 들어가면 안 된다.
git check-ignore -v artifacts/mlflow.db artifacts/mlruns두 경로 모두 무시 규칙에 걸리는지 확인한다. sqlite 파일은 바이너리라 diff가 무의미하고, 매 실행마다 바뀌어 커밋이 지저분해진다.